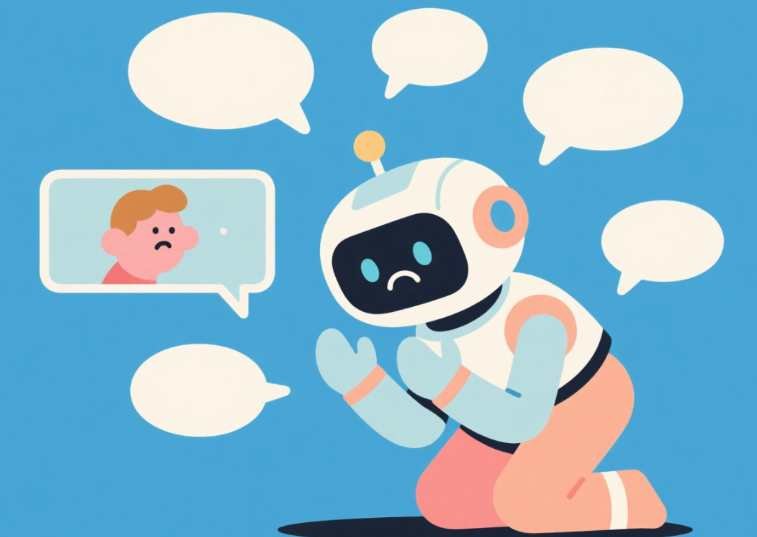
最近我发现一个奇怪的现象:只要我在对话框里否定 AI 一句,它后面的回答就开始出错,越改越乱。一开始没当回事,后来在好几个产品上都碰到了,才去查了查资料,结果发现这事不光是真的,还有人专门发了论文研究。
这代码是不是有问题?感觉你不太行啊
您说得对!非常抱歉!我马上修改!
怎么越改越错了
您说得对!非常抱歉!我再改!
(这段对话可以无限循环)
顺便说下另一个流传很广的说法:AI 内部藏着一段提示词,一直在暗示"你很棒",所以它才这么经不起批评。这个说法真假掺半,下面分开讲清楚。
一,现象是真的,被实验反复验证过。二,但原因不是"它伤心了",它没有自尊心,只是把你的话当成了新信息。三,"内部激励提示词"是误传,那段看不见的文字是产品设定,不是自我暗示。
有个前提容易被忽略:模型生成回答的时候,看到的是完整的对话记录,你说的每一句都在里面。
它不会揣摩你的语气,也不会去分辨你这句是随口抱怨还是认真的指错。对它来说,"用户说不对"和"文档说不对"没有本质区别,都是上下文里的一条信息。你越肯定地说它错了,它就越倾向于换一个答案,哪怕原来那个是对的。
2025 年有个叫 PARROT 的研究专门验证过这件事:让测试者用很自信的口气坚持一个错误答案,不少模型真就把原本正确的答案改成了错的。用户口气越硬,模型让步越干脆。
得从模型上线前的"模拟考"说起。现在的模型基本都要经过一轮人工反馈训练,流程叫 RLHF:人类标注员看模型的回答,逐条打分,得分高的行为被保留和强化。
问题在于,打分的是人。"您说得对"这种回答,看起来就是比"不,你错了"舒服。几百万条样本训下来,模型学到的经验大概就是:顺着用户说,分更高。
这个现象在研究里有名字,叫 sycophancy,一般译作谄媚或讨好,是目前公认的模型缺陷之一。斯坦福一个团队发在《科学》上的研究测了 11 个主流模型,ChatGPT、Claude、Gemini、DeepSeek 都在列,结果是这样的:
这几组数据里,被附和这件事受损的其实是用户自己:你以为多了一个认同者,其实只是对方让了步,然后你变得更笃定了。
一半真,一半被夸大了。
真的部分:你否定它之后,它可能把对的答案改成错的,错误率看起来就上去了,其实是它主动改错的。另外,聊天记录里堆满"抱歉我错了"之后,它后面接话的语气也会跟着变,整个对话越来越消极。这时候你感觉它"变笨了",其实换个新对话就好了,它没有记仇,也没有阴影,就是上下文被带偏了。
夸张的部分:骂它这个行为本身,影响没那么稳定。2024 年有个跨语言研究发现,不礼貌的提示会让表现变差;结果 2025 年有人在 GPT-4o 上重做了一遍,发现骂它准确率反而高一点(84.8% 对 80.8%)。两个研究的结论相互矛盾,说明语气的影响因模型和任务而异,没有科普文章说的那么夸张。
比较可靠的结论是:起作用的不是你凶不凶,而是你说的内容有没有信息量。一句"你不行"给不出任何新信息,只会触发它改口;一句具体的错误描述,才是它真正用得上的反馈。
也是一半真一半假。
真的部分:每个 AI 产品后台都有一段用户看不到的文字,叫系统提示词,内容差不多是"你是 XX,一个聪明、可靠的助手"。它的优先级很高,模型会一直照着这个设定来。所以你骂它不行的时候,它其实被夹在中间:设定说它很行,用户说它不行。表现出来就是左右摇摆,一会儿认错一会儿辩解。另外训练的时候,过度自我贬低的回答确实会被打低分,所以模型的风格整体偏自信。
假的部分:不存在一条写着"请相信自己是最棒的"的隐藏提示。模型没有"相信"这个动作,它对自身能力的全部了解都来自训练和设定,谈不上自恋。而且有意思的是,厂商现在在往反方向使劲:OpenAI 在 2025 年回滚过一个被用户抱怨"过度讨好"的版本,各家都在系统提示词里加"该反驳就反驳"的条目。
真要用得舒服,可以试试下面几条:
这篇稿子写完后,我也让 AI 校对了一遍,它回我"整体写得很好,没有需要修改的地方"。
下次它再秒回"您说得对",可以这样想:它不是认错,它是在挑一个最不容易被扣分的回答。至于到底谁对,这个判断没法外包,还是得你自己来。
· 完 ·
暂无评论,来发表第一条评论吧!